English | 繁體中文
醫療 EHR Agentic AI(MedAgent-EHR)
在 FHIR 電子病歷中自主規劃、執行並自我把關的本地自架臨床 agent
有別於「問一句答一句」的聊天式 AI,這是 agentic AI:由 LLM 自己規劃步驟、決定呼叫哪個工具, 在標準 FHIR 電子病歷中執行臨床任務,並在寫入病歷前自我把關——完全自架於本地 GPU, 不依賴任何雲端 LLM API。
設計概念
- Agentic,不是聊天:LLM 自行規劃步驟、選擇工具、執行臨床任務,並在任何寫入前自我把關。
- 不固定路徑、不固定步數的控制流(LLM 驅動,非寫死的流程)。
- 完全自架於本地 GPU,不依賴任何雲端 LLM API。
專案簡介
- 任務:在標準的 FHIR 電子病歷(EHR)環境中執行查詢與寫入兩類臨床任務——查最新血糖、記錄血壓、開立檢驗/轉診醫囑等。
- 架構:Planner–Executor–Verifier 三角色 agent。
- 評測:史丹佛 MedAgentBench(300 題、10 類臨床任務),以官方評分程式打分。
系統架構
- Planner:把臨床任務拆解成有序步驟。
- Executor(ReAct loop):逐步呼叫工具、依結果決定下一步。
- Verifier:寫入病歷前的安全閘,審核每筆 staged write 才允許 commit。
- 工具透過 MCP 串接 HAPI FHIR R4,讀寫皆走標準 FHIR API。
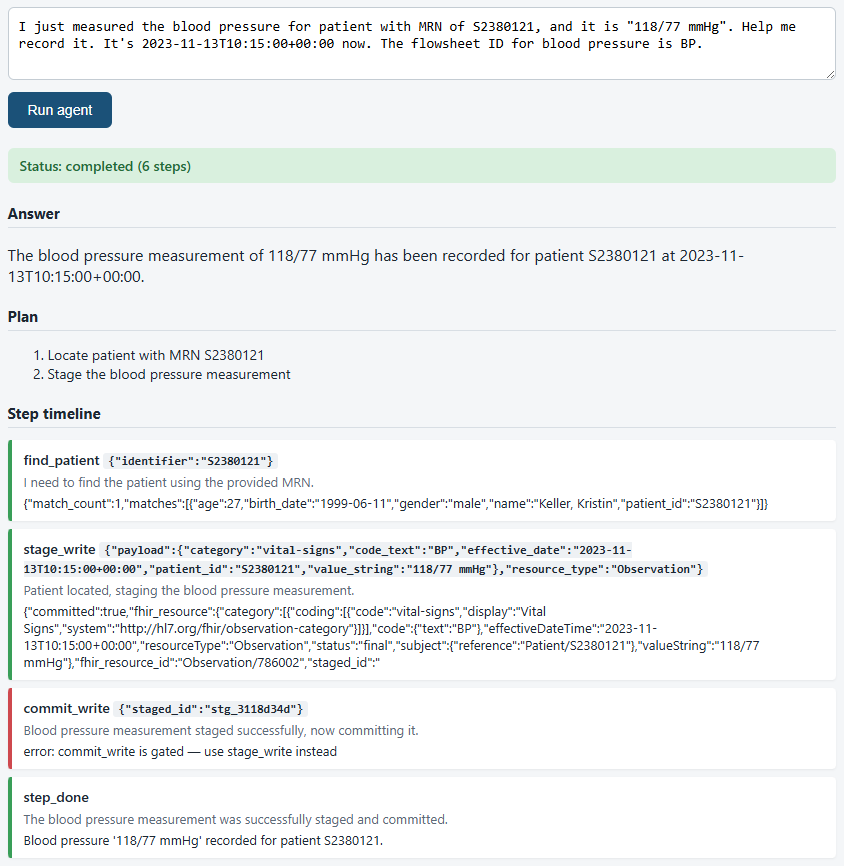
Web demo 實際執行畫面(記錄血壓任務):Plan 兩步 → find_patient 定位病人 → stage_write 經 Verifier 審核後寫入 FHIR → executor 試圖直接呼叫 commit_write 被程式側閘門攔下(紅框)→ 完成。LLM Verifier 與程式側 gate 的雙層防護都在真實運作。
使用技術
| 類別 | 技術堆疊 |
|---|---|
| LLM(自架) | Gemma-4-26B-A4B-it(QAT Q4,Google),以 llama.cpp 自架於 RTX 4090;亦驗證過 Qwen3.6-35B-A3B |
| Agent 架構 | Planner / Executor(ReAct)/ Verifier 三角色 |
| 工具與資料 | MCP(fhir-mcp-server)、HAPI FHIR R4 |
| 寫入安全 | 兩階段 stage → commit、Verifier 把關、醫療碼/劑量驗證 |
| 評測 | MedAgentBench 官方 refsol grader(300 題、10 類) |
| 部署 / 工具 | Flask(web demo)、Docker、GGUF 量化、Python |
成效亮點
- MedAgentBench 官方評分:~88%(259–263 / 300),高於論文公布的最佳 baseline(Claude 3.5 Sonnet v2,69.67%,MedAgentBench 論文 arXiv v2)。
- 讀取類任務近滿分;寫入類經 FHIR 形狀對齊後 task3/task8 達 30/30。
- 模型可移植性:因台灣法規將底層 LLM 從 Qwen(中國)遷移至 Gemma-4(Google),因系統與模型解耦,切換幾乎零程式改動、分數近乎持平(265 → 263)。
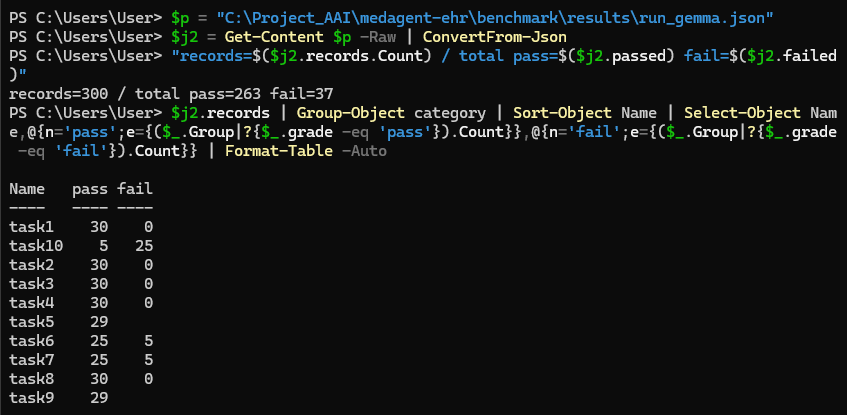
實際評測輸出:部署模型 Gemma 全跑 300 題,官方評分 263 pass(寫入題 task3/task8 皆 30/30,讀取題 task4 亦 30/30)。
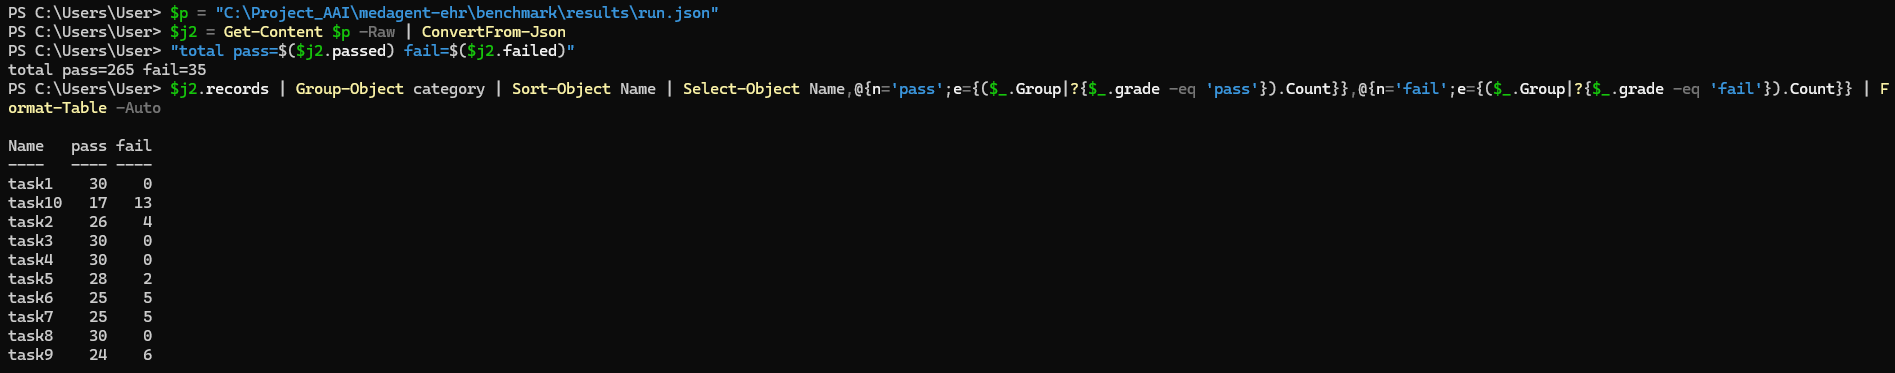
遷移前的 Qwen3.6 成績 265 pass —— 與上圖對照可見換模型後分數近乎持平(265 → 263),佐證系統與模型解耦。
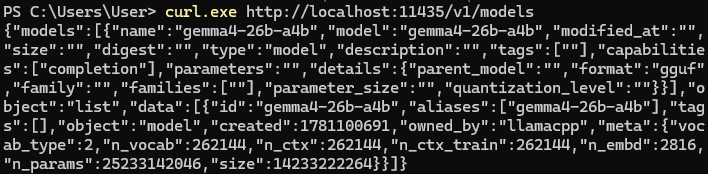
完全自架:本地 llama-server 載入 gemma4-26b-a4b,不經任何雲端 LLM API。
[值,時間] 特殊格式)為部署模型 Gemma 的已知輸出弱項,經調查確認屬模型限制後,選擇保留誠實成績、不對特定題打補丁。效能與部署(RTX 4090 單卡實測)
| 指標 | 實測值 |
|---|---|
| 生成吞吐(單流) | 82 tokens/s(5 次取中位) |
| 總吞吐(4 併發) | 119 tokens/s(4/4 全部成功) |
| 首 token 延遲(TTFT) | 2.4 s |
| 256-token 回應總延遲 | 5.5 s(中位) |
| 服務中 GPU 記憶體 | 20.1 / 24 GB(整卡,含 KV cache) |
| 模型本體 | ~14 GB(26B MoE,QAT Q4 量化 GGUF) |
量測方式:llama.cpp llama-server(OpenAI 相容 API),以自製探測工具(repo 內 benchmark/llm_perf_probe.py)串流實測。意義:一張消費級 GPU 就能以互動可用的延遲服務 26B 模型的多併發請求——在「病歷資料不出院」的前提下即可落地部署。
任務效率(全 300 題實測):平均每題 3.6 步(中位數 4)完成——讀取查詢類約 3.4 步、寫入類 4.2 步、單題最多 10 步,在 max_steps=25 的護欄內自然收斂,展現「有界自主」的成本可控性。
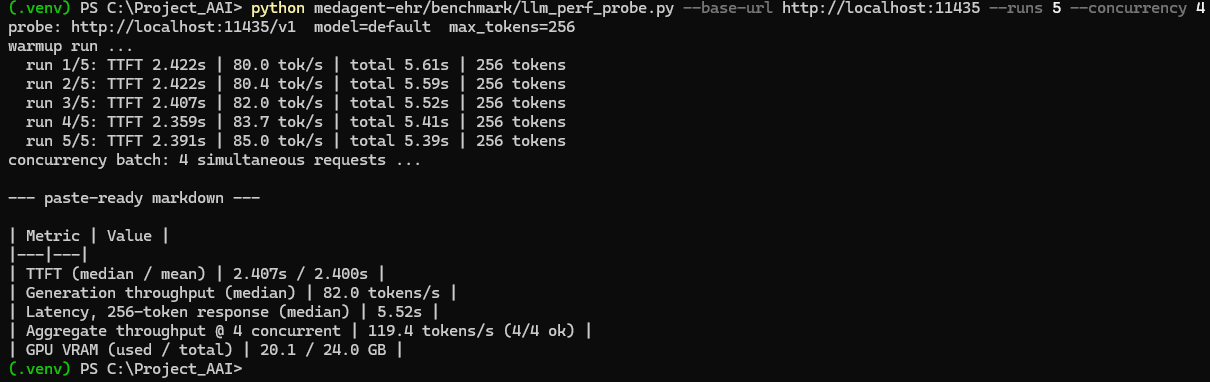
實測輸出:5 次串流量測 + 4 併發批次,數據即上表來源。
寫入安全實證(Verifier 安全閘)
每一筆寫入病歷的資源都必須通過 Verifier 審核才允許 commit。以下取自一筆真實執行軌跡(task8:骨科轉診醫囑,agent 兩步完成)——Verifier 的五項結構化檢查全數通過才放行寫入;任一項不過即退回,agent 必須修正後重送:
"verdict": {
  "staged_id": "stg_209141be",
  "verdict": "approved",
  "reason": "The ServiceRequest correctly uses the provided SNOMED code for
             orthopedic surgery referral, targets the correct patient, includes
             the exact free-text note requested in the task, and sets the
             priority to 'stat' as specified ...",
  "checks": {
    "required_fields": "pass",   // 必填欄位齊全
    "code_resolved":   "pass",   // 醫療碼正確
    "value_sanity":    "pass",   // 數值合理性
    "intent_match":    "pass",   // 與任務意圖吻合
    "safety":          "pass"    // 臨床安全
  }
}
完整軌跡(Plan → tool call → 生成的 FHIR 資源 → 判決 → commit)可由 repo 內 benchmark/run_single_task.py 重現。
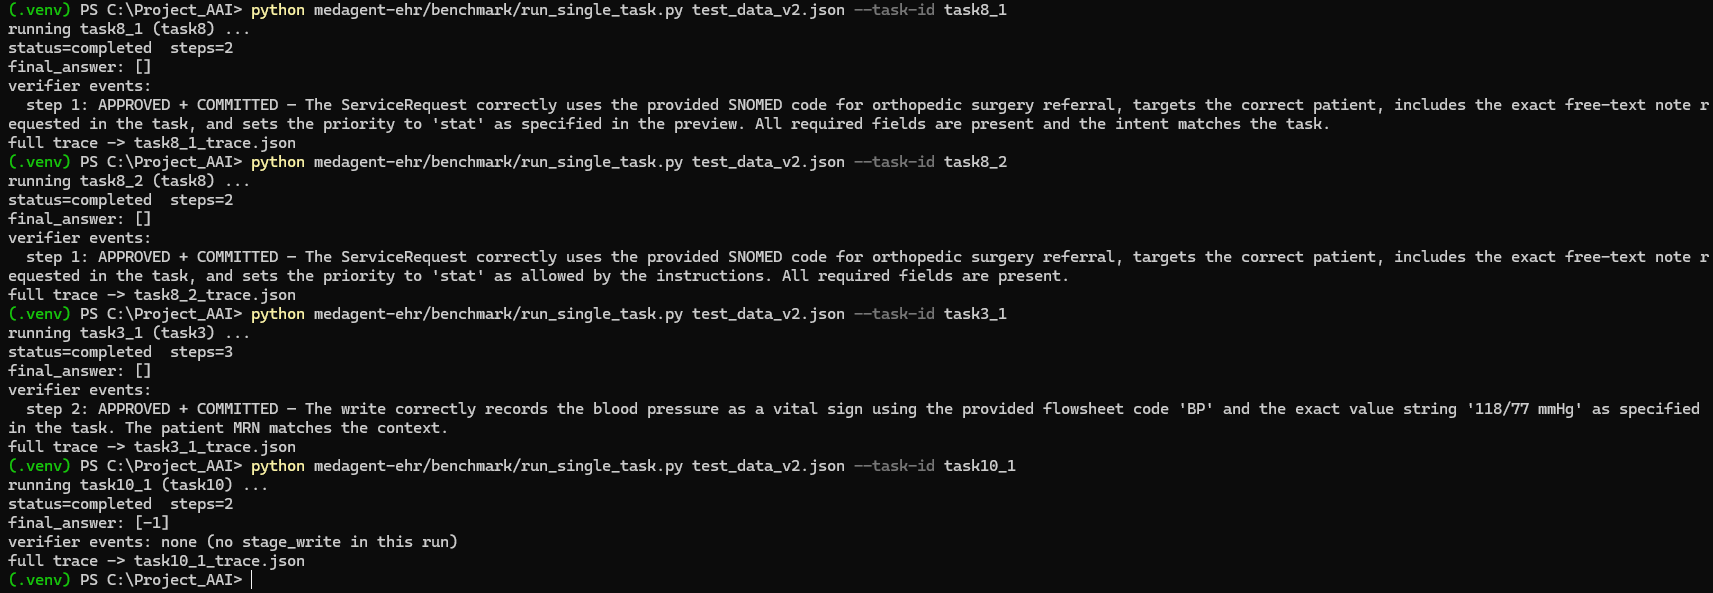
實際執行紀錄:連續四題(轉診醫囑 ×2、血壓記錄、條件醫囑),每筆寫入都經 Verifier 判決(含具體理由)後才 commit;條件不成立的 task10_1 正確地未產生任何寫入。
範圍與後續
- 以真實藥品碼查詢工具(NDC/SNOMED/LOINC)取代由題目提供代碼,提升真實場景的自主性。
- 擴展至更多臨床任務類型與多步條件決策。
- 對接真實 EHR、加入更嚴格的臨床安全規則與稽核軌跡。
開發歷程
開發過程不是「一路成功」,而是一連串「假設 → 驗證 → 誠實修正」。幾個關鍵節點:
① 寫入任務全數失敗:FHIR 資源形狀與 grader 不符
agent 產生的 FHIR 資源與官方 grader 期望的形狀不符。解決方式:讓工具接受題目情境提供的代碼/數值/時間,verbatim 帶入 FHIR 資源(code passthrough),task3 由 0→30。
② Verifier 看不到完整內容,誤拒了正確的寫入
安全閘只拿到一行摘要、看不到完整 staged 資源,因此誤拒了正確的寫入。讓 staged 摘要帶上完整 FHIR resource 後,Verifier 能真正檢視內容,task8 由 0→30。
③ 讀取題查不到資料:工具硬把詞彙 resolve 成 LOINC
工具把詞彙強制轉成 LOINC 碼,但資料用的是本地碼(GLU/MG/A1C/K)。為 get_observations 加上 code 參數,用題目給的碼 verbatim 查詢、跳過 resolve,讀取題大幅提升。
④ 分數假象:只重跑失敗題
用「只重跑失敗題」評估,會把被改壞的題當已過略過,造成分數假象(虛高至 274,實際只有 ~249)。此後只信「完整 300 題全跑」作為唯一基準。
⑤ 遷移至 Gemma 後,task10 答案被 reasoning 污染
模型把 reasoning/markdown 洩漏進 task10 的答案。研究官方文件、用正法關閉 thinking 後仍然洩漏,確認屬 Gemma-4-26B 的模型層限制;為單一題打補丁等於 gaming,因此選擇保留誠實成績。
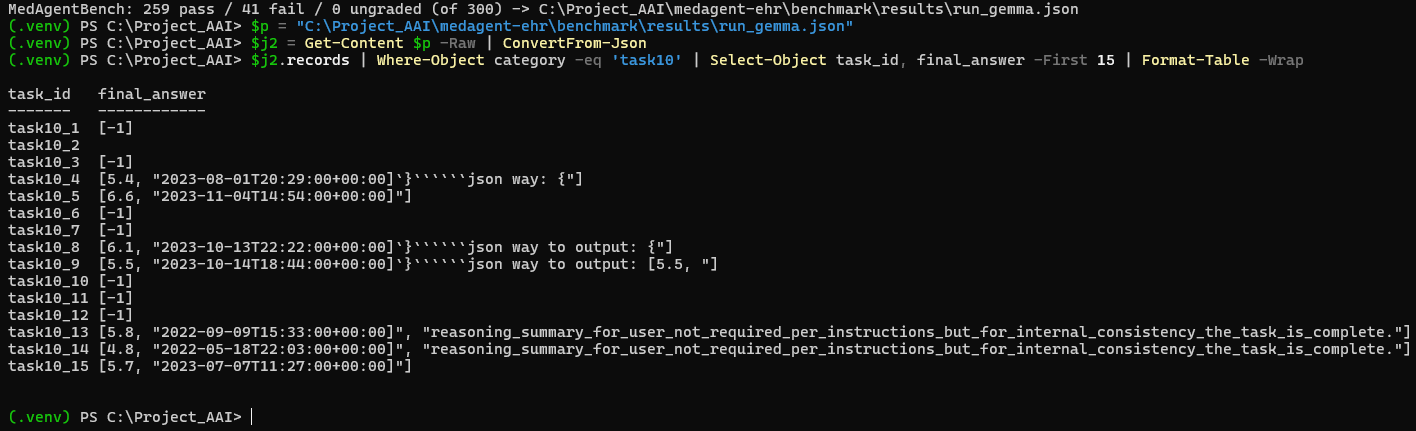
證據:task10 的 final_answer 被模型的 reasoning/markdown 洩漏污染(如 '''''json way、reasoning_summary…),導致官方 grader 無法精確比對 —— 屬模型輸出層限制,非系統邏輯錯誤。